9.5 시계열
9.5 시계열
최근 R 사용자들 사이에서 시계열 분석에 널리 쓰이는
forecast,tseries,xts,zoo,tsibble,fable같은 패키지들은 Base R 범위를 벗어나므로 다루지 않습니다.
아래처럼 AirPassengers(1949년 1월부터 1960년 12월까지 144개월간의 국제선 항공 승객 수, 단위: 천 명)를 그냥 하나의 평범한 숫자 벡터로 취급해 평균과 표준편차만 요약해 보면 어떤 문제가 생길까요?
평균 약 280(천 명), 표준편차 약 120(천 명)이라는 숫자 자체는 계산상 틀리지 않습니다. 그러나 이 숫자만 봐서는 "12년 동안 승객 수가 꾸준히 늘어 왔다"는 추세(trend) 도, "매년 7~8월에 유독 승객이 몰린다"는 계절성(seasonality) 도 전혀 드러나지 않습니다. mean()·sd()(9.2절)는 관측치들이 서로 독립적으로 흩어져 있다고 가정하고 그 분포의 중심과 퍼짐만 요약하는 함수인데, 시계열 데이터는 애초에 그 가정 자체가 성립하지 않기 때문입니다.
이 데이터를 시간 순서대로 그려 보면 사정이 분명해집니다.
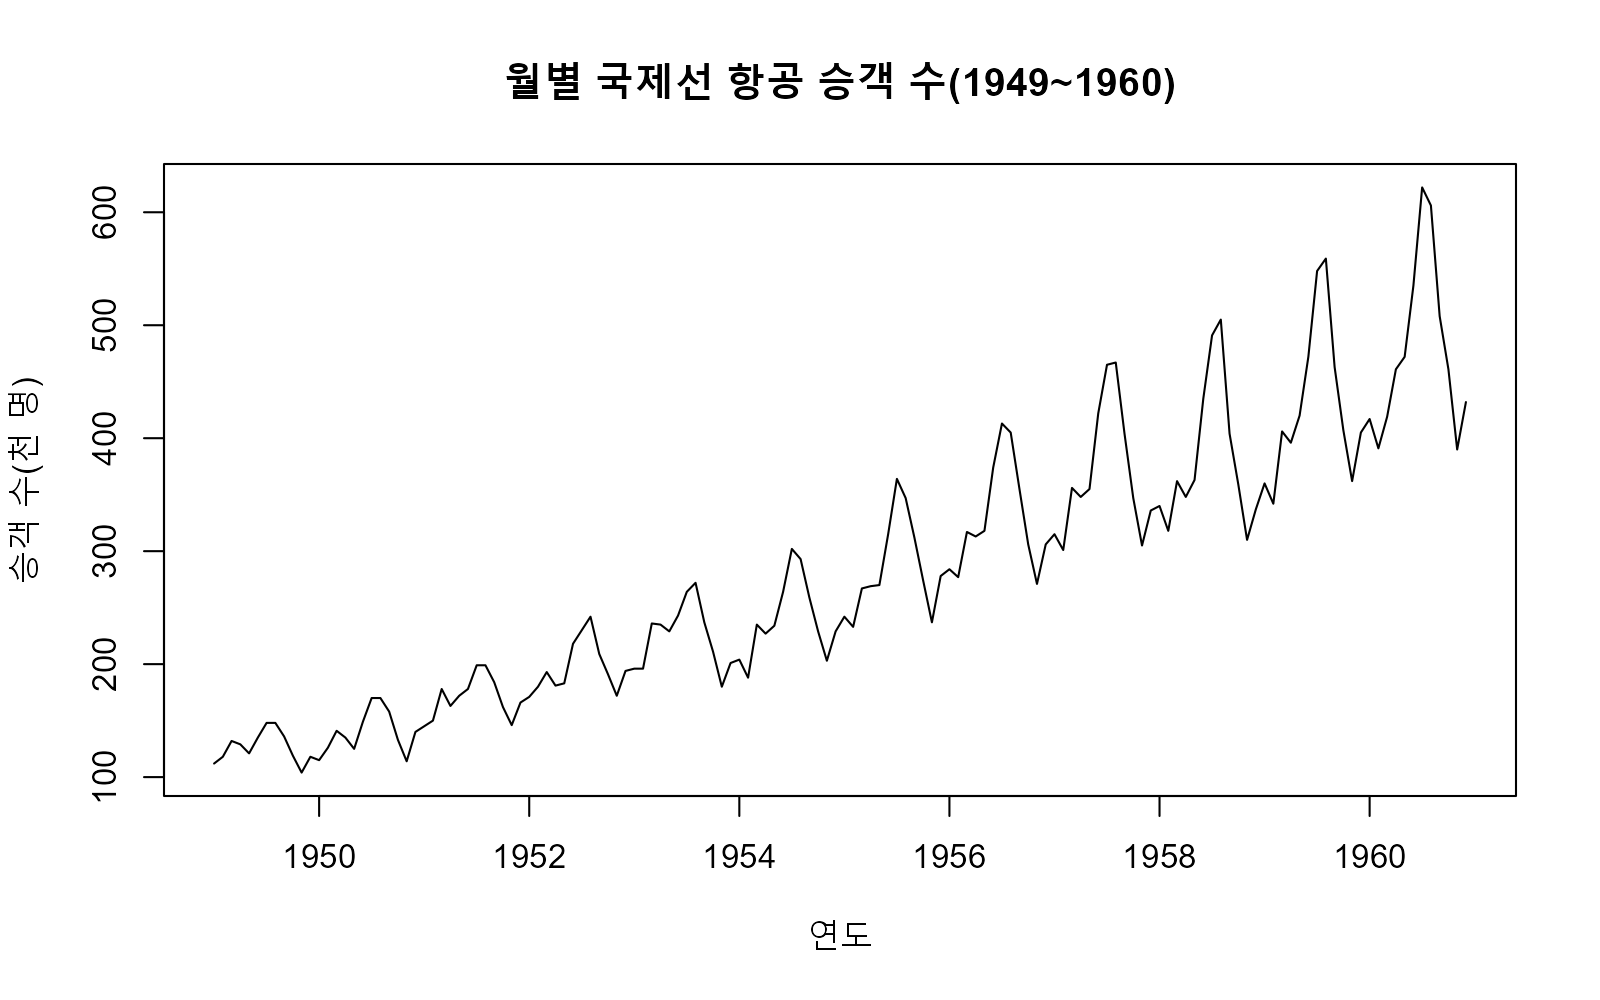
이 그래프를 그려 보면 ① 해가 갈수록 승객 수가 우상향하는 뚜렷한 추세, ② 매년 여름철(7~8월)에 정점을 찍고 겨울철에 저점을 찍는 12개월 주기의 계절 패턴, ③ 그리고 시간이 지날수록 오르내림의 폭 자체가 점점 커지는 모습을 함께 확인할 수 있습니다. mean() 하나로는 결코 포착할 수 없는 이 구조를 다루려면, "몇 번째로 관측된 값인가"가 아니라 "언제 관측된 값인가"라는 시간 정보를 데이터에 함께 담아 둘 방법이 필요합니다.
R은 "시간 순서가 있는 데이터를 다룬다"는 이 문제를 목적별로 나누어 다음과 같은 함수들로 제공합니다.
| 목적 | 사용하는 함수 |
|---|---|
| 시계열 객체 만들기·시간 정보 확인·부분 구간 선택 | ts(), start(), end(), frequency(), cycle(), time(), window() |
| 추세를 제거하거나 변화량 자체에 주목하기(정상화) | diff(), lag() |
| 국소 구간의 평균으로 잡음을 줄이거나 재귀적으로 값을 누적하기 | filter() |
| 추세·계절성·불규칙 성분으로 분리하기 | decompose(), stl() |
| 관측치 사이의 시차별 상관관계(자기상관) 파악하기 | acf(), pacf(), ccf(), Box.test() |
| 과거 값들의 선형결합으로 미래를 예측하기(자기회귀) | ar(), arima(), predict() |
| 최근 값에 더 큰 가중치를 두어 추세·계절성까지 함께 예측하기(지수평활) | HoltWinters(), predict() |
시계열(time series) 이란 일정한 시간 간격으로 순서대로 관측된 값들의 수열을 말합니다. R은 이를 ts 클래스 객체로 표현하는데, 일반 벡터와 달리 시작 시점(start)·종료 시점(end)·관측 빈도(frequency)라는 세 가지 시간 메타데이터를 tsp라는 속성(attribute)에 함께 담아 둔다는 점이 핵심입니다. 이 메타데이터 덕분에 R은 "12번째 값"이 아니라 "1950년 1월의 값"이라는 것을 인식하고, 시간 축을 기준으로 그래프를 그리거나 특정 구간을 잘라내는 등의 연산을 자동으로 처리해 줍니다.
ts()
ts(data = NA, start = 1, end = numeric(), frequency = 1, deltat = 1, ts.eps = getOption("ts.eps"), class, names)는 평범한 숫자 벡터(또는 행렬)에 시간 메타데이터를 붙여 시계열(ts) 객체로 변환하는 함수입니다. 시계열 관련 함수들은 대부분 입력으로 ts 객체를 기대하므로, 이 절에서 다루는 모든 분석은 사실상 ts()로 시작한다고 볼 수 있습니다.
주요 인자
data: 시계열로 변환할 값들. 보통 하나의 수치 벡터를 넣지만, 여러 열을 가진 행렬이나 데이터프레임을 넣으면 여러 시계열을 한 번에 묶은 다변량 시계열(mts클래스)이 만들어집니다.start: 첫 번째 관측치의 시점. 연 단위 데이터라면2023처럼 숫자 하나만 쓰고, 연 안에 하위 주기가 있는 데이터라면c(2023, 1)(2023년의 1번째 주기, 예를 들어 1월 또는 1분기)처럼 길이 2의 벡터로 지정합니다.end: 마지막 관측치의 시점.start와frequency, 데이터 길이 중 셋만 알아도 나머지 하나는 계산할 수 있으므로,start와frequency만 지정하면end는 보통 생략해도 됩니다.frequency: 한 "상위 주기"(보통 1년) 안에 들어 있는 관측치의 개수입니다. 월별 자료는12, 분기별 자료는4, 연간 자료는1, 주별 자료는 관례상52를 씁니다. 이름과 달리 "초당 반복 횟수" 같은 물리적 주파수가 아니라 주기 안의 관측 칸 수를 뜻한다는 점에 유의해야 합니다.deltat:frequency의 역수(예: 월별 자료라면1/12)로 관측 간격을 지정하는 대안적인 방법입니다.frequency와deltat을 동시에 지정하면 오류가 나므로 둘 중 하나만 사용합니다.ts.eps: 여러 시계열의 시간축이 같은지 비교할 때 허용할 오차범위. 기본값은options("ts.eps")(보통1e-5)이며 거의 건드릴 일이 없습니다.class,names: 반환될 객체의 클래스와 각 열의 이름을 지정합니다.data의 열 개수 등을 보고 자동으로 결정되므로 직접 지정하는 경우는 드뭅니다.
가상의 분기별 매출 자료를 ts 객체로 만들어 보면, 출력 형태부터 일반 벡터와 다르다는 것을 바로 알 수 있습니다.
sales <- c(320, 340, 355, 400, 330, 350, 365, 410, 345, 365, 380, 420)
sales_ts <- ts(sales, start = c(2023, 1), frequency = 4)
sales_ts
#>      Qtr1 Qtr2 Qtr3 Qtr4
#> 2023  320  340  355  400
#> 2024  330  350  365  410
#> 2025  345  365  380  420

class(sales_ts)
#> [1] "ts"

str(sales_ts)
#> Time-Series [1:12] from 2023 to 2026: 320 340 355 400 330 350 365 410 345 365 ...
12개의 숫자가 그저 나열되는 것이 아니라, 연도(2023~2025)와 분기(Qtr1~Qtr4)가 표 형태로 자동 배치되어 출력됩니다. frequency를 지정하지 않으면 기본값 1이 적용되어 그냥 순서만 있는(연간 자료와 동일하게 취급되는) 시계열이 됩니다.
ts 객체는 내부적으로 start, end, frequency 세 값을 tsp라는 속성 하나에 압축해 저장합니다. tsp() 함수로 이 값을 직접 확인할 수 있습니다.
앞의 두 값은 시작·종료 시점을 "연도.연중비율" 형태의 소수로 표현한 것이고, 마지막 값이 frequency입니다. 이 세 숫자만 있으면 R은 각 관측치가 정확히 몇 년 몇 분기(또는 몇 월)의 값인지 언제든 역산할 수 있습니다.
시계열의 정보 확인과 부분 선택
ts 객체는 시간 메타데이터를 담고 있으므로, "언제부터 언제까지의 자료인가", "특정 구간만 잘라내고 싶다" 같은 질문에 전용 함수로 바로 답할 수 있습니다.
주요 함수
start(x),end(x): 시계열x의 시작·종료 시점을c(연도, 하위주기)형태로 반환합니다.frequency(x):x의frequency값(연간 관측 횟수)을 반환합니다. 참고로 관측 간격(초 단위가 아니라 "몇 분의 1년인가")을 알고 싶다면 그 역수인deltat(x)를 사용합니다.cycle(x): 각 관측치가 그 해(또는 그 상위 주기) 안에서 몇 번째 위치인지를 같은 길이의 시계열로 반환합니다. 월별 자료라면 1~12가 반복됩니다.time(x): 각 관측치의 시점을 "연도.연중비율" 형태의 수치형 시계열로 반환합니다.window(x, start = NULL, end = NULL, frequency = NULL, deltat = NULL, extend = FALSE, ts.eps = getOption("ts.eps"), ...): 시계열x에서start부터end까지의 연속 구간만 잘라냅니다. 벡터 인덱싱(x[1:10])과 달리 실제 관측 순번이 아니라 시간을 기준으로 구간을 지정한다는 점이 다릅니다.extend:TRUE로 지정하면 지정한 구간이 원래 시계열의 범위를 벗어나도 그 부분을NA로 채워 확장합니다. 기본값FALSE에서는 범위를 벗어난 시점을 요청하면 오류가 납니다.
data(AirPassengers)
start(AirPassengers)
#> [1] 1949    1
end(AirPassengers)
#> [1] 1960   12
frequency(AirPassengers)
#> [1] 12
length(AirPassengers)
#> [1] 144
1949년 1월부터 1960년 12월까지 매달(frequency = 12) 관측된 144개의 값이라는 것을 함수 호출만으로 바로 확인할 수 있습니다.
head(cycle(AirPassengers), 15)
#>      Jan Feb Mar Apr May Jun Jul Aug Sep Oct Nov Dec
#> 1949   1   2   3   4   5   6   7   8   9  10  11  12
#> 1950   1   2   3

head(time(AirPassengers), 5)
#>           Jan      Feb      Mar      Apr      May
#> 1949 1949.000 1949.083 1949.167 1949.250 1949.333
window()로 1954~1956년, 3년 치 구간만 잘라내면 다음과 같습니다.
window(AirPassengers, start = c(1954, 1), end = c(1956, 12))
#>      Jan Feb Mar Apr May Jun Jul Aug Sep Oct Nov Dec
#> 1954 204 188 235 227 234 264 302 293 259 229 203 229
#> 1955 242 233 267 269 270 315 364 347 312 274 237 278
#> 1956 284 277 317 313 318 374 413 405 355 306 271 306
"매년 6월 값만 모아 보고 싶다"처럼 연속 구간이 아니라 특정 주기만 골라내고 싶을 때는 window() 대신, 위에서 구한 cycle() 결과를 논리 조건으로 활용해 인덱싱합니다.
💡
window()와 일반 인덱싱(x[ ])의 차이:x[1:24]처럼 순번으로 자르면 결과가 평범한 숫자 벡터가 되어 시간 정보를 잃어버리지만,window(x, start = ..., end = ...)로 자르면 결과도 여전히ts객체이므로 시작·종료 시점,frequency가 그대로 유지됩니다. 이후 다룰acf(),arima()등은 입력이ts객체인지에 따라 축의 눈금 표시나 계절 주기 인식이 달라지므로, 시계열의 일부 구간만 떼어 분석할 때는 되도록window()를 사용하는 것이 안전합니다.
diff(), lag()
AirPassengers는 해가 갈수록 값 자체가 계속 커지는 뚜렷한 추세를 갖고 있습니다. 그런데 뒤에서 다룰 acf()나 ar() 같은 함수들은 "평균과 분산이 시간에 따라 일정하다"는 정상성(stationarity) 을 전제로 만들어졌습니다. 값 자체의 수준이 아니라 "전월 대비 얼마나 변했는가"에 주목하면, 추세로 인한 비정상성을 상당 부분 제거하고 정상성에 더 가까운 계열을 얻을 수 있습니다.
diff(x, lag = 1, differences = 1, ...)는 시계열(또는 벡터) x에서 lag시점 이전 값과의 차이를 계산해 반환하는 함수입니다.
주요 인자
x: 차분할 시계열 또는 벡터.lag: 몇 시점 이전 값과 비교할지 지정합니다. 기본값1은 바로 이전 시점(월별 자료라면 전월)과 비교하고, 계절 주기와 같은 값(월별 자료라면12)을 지정하면 "전년 동월 대비" 차이를 구할 수 있습니다.differences: 차분을 몇 번 반복할지 지정합니다.1이면 1차 차분(변화량),2이면 1차 차분을 한 번 더 차분한 2차 차분(변화량의 변화량, 즉 가속도에 해당)을 얻습니다.
결과의 길이는 원래 길이보다 lag × differences만큼 짧아집니다. 맨 앞 관측치들은 비교할 과거 값이 없기 때문입니다.
head(diff(AirPassengers), 14)          # 전월 대비 증감
#>      Jan Feb Mar Apr May Jun Jul Aug Sep Oct Nov Dec
#> 1949       6  14  -3  -8  14  13   0 -12 -17 -15  14
#> 1950  -3  11  15

head(diff(AirPassengers, lag = 12), 14)  # 전년 동월 대비 증감(계절 차분)
#>      Jan Feb Mar Apr May Jun Jul Aug Sep Oct Nov Dec
#> 1950   3   8   9   6   4  14  22  22  22  14  10  22
#> 1951  30  24

head(diff(AirPassengers, differences = 2), 14)  # 2차 차분
#>      Jan Feb Mar Apr May Jun Jul Aug Sep Oct Nov Dec
#> 1949           8 -17  -5  22  -1 -13 -12  -5   2  29
#> 1950 -17  14   4 -21
lag = 1로 구한 전월 대비 증감은 매년 여름 직전(6~7월)에 크게 뛰고 가을~겨울에 감소하는, 여전히 계절 패턴이 섞인 모습을 보입니다. 반면 lag = 12로 구한 전년 동월 대비 증감은 계절 요인이 상쇄된 "순수한 연간 성장분"에 가까워, 값이 모두 양수이고 전반적으로 완만하게 커지는 추세만 남습니다.
lag(x, k = 1, ...)는 diff()처럼 값을 계산하는 함수가 아니라, 시계열 x의 시간축(tsp)만 k만큼 이동시켜 반환하는 함수입니다. 이름 때문에 diff()와 혼동하기 쉬우므로, 작은 예제로 동작 원리를 정확히 확인해 두는 것이 좋습니다.
x <- ts(101:105, start = 2020)
x
#> Time Series:
#> Start = 2020
#> End = 2024
#> Frequency = 1
#> [1] 101 102 103 104 105

lag(x, k = -1)   # 시간을 1기 뒤로 미룸(시작 시점이 1 늘어남)
#> Time Series:
#> Start = 2021
#> End = 2025
#> Frequency = 1
#> [1] 101 102 103 104 105
값 자체(101~105)는 바뀌지 않고, 오직 "이 값들이 몇 년도의 관측치인가"라는 시간표만 한 칸 밀렸다는 점에 주목해야 합니다. 이 특성 때문에 lag()를 단독으로 쓰기보다는, 아래처럼 ts.union()으로 원래 시계열과 나란히 이어 붙여 "이전 시점 값"을 현재 시점의 열로 가져오는 용도로 주로 사용합니다.
ts.union(x, x_이전값 = lag(x, k = -1))
#> Time Series:
#> Start = 2020
#> End = 2025
#> Frequency = 1
#>        x x_이전값
#> 2020 101       NA
#> 2021 102      101
#> 2022 103      102
#> 2023 104      103
#> 2024 105      104
#> 2025  NA      105
이렇게 정리하면 회귀분석에서 "어제 값을 설명변수로 써서 오늘 값을 예측"하는 시차변수(lagged variable)를 손쉽게 만들 수 있습니다.
⚠️ 주의:
k의 부호가 직관과 반대일 수 있습니다.lag(x, k = 1)은 시간을 1기 앞으로 당기고(시작 시점이 줄어들고),lag(x, k = -1)은 1기 뒤로 미룹니다(시작 시점이 늘어남). "1시차 이전 값을 현재 위치에 맞춰 보고 싶다"는 회귀분석에서 흔한 목적에는k = -1을 써야 한다는 점을 반드시 기억해야 합니다.
filter()
filter(x, filter, method = c("convolution", "recursive"), sides = 2L, circular = FALSE, init = NULL)는 시계열 x에 선형 필터를 적용하는 함수로, method를 어떻게 지정하느냐에 따라 전혀 다른 두 가지 용도로 쓰입니다.
주요 인자
x: 필터를 적용할 시계열(또는 벡터).filter: 필터 계수(가중치) 벡터.method: 필터 적용 방식."convolution"(기본값) : 이웃한 관측치들에filter로 지정한 가중치를 곱해 더하는 이동평균(moving average) 방식입니다. 잡음을 걸러내고 추세를 부드럽게 드러낼 때 씁니다."recursive": 과거의 필터링된 결과값을 다시 입력으로 사용하는 방식으로,y[t] = x[t] + filter[1]*y[t-1] + filter[2]*y[t-2] + ...형태로 계산됩니다. 뒤에서 다룰 자기회귀(AR) 과정을 흉내 내거나 시뮬레이션할 때 사용합니다.sides:method = "convolution"일 때만 의미가 있으며, 가중치를 현재 시점 기준 어느 쪽 이웃에 적용할지를 정합니다.2(기본값)는 앞뒤로 대칭인 가중치를 적용하는 중심이동평균이고,1은 현재와 과거 시점에만 가중치를 적용합니다.circular:TRUE로 지정하면 데이터의 양 끝을 원형으로 이어 붙여, 시계열의 시작·끝에서도NA가 생기지 않게 처리합니다. 계절처럼 주기적인 데이터에 적합합니다.init:method = "recursive"일 때 계산을 시작하기 위해 필요한 초기값들입니다.
3개월 단순이동평균으로 잡음을 줄여 보면, 앞뒤 1개월씩 걸쳐 평균을 내는 만큼 맨 앞 값 하나가 NA로 남는 것을 확인할 수 있습니다.
ma3 <- filter(AirPassengers, filter = rep(1/3, 3), method = "convolution", sides = 2)
head(ma3, 8)
#>           Jan      Feb      Mar      Apr      May      Jun      Jul      Aug
#> 1949       NA 120.6667 126.3333 127.3333 128.3333 134.6667 143.6667 144.0000
월별 자료에서 12개월 주기의 계절성을 걸러낸 추세만 뽑아내고 싶을 때는, 앞뒤 6개월씩 총 13개 항목에 가중치를 주되 양 끝 항목만 절반의 가중치(1/24)를 주는 12개월 중심 이동평균을 자주 사용합니다(이 가중치 구성은 뒤에서 다룰 decompose()가 내부적으로 사용하는 것과 동일합니다).
w <- c(0.5, rep(1, 11), 0.5) / 12
ma12 <- filter(AirPassengers, filter = w, sides = 2)
head(ma12, 15)
#>           Jan      Feb      Mar      Apr      May      Jun      Jul      Aug
#> 1949       NA       NA       NA       NA       NA       NA 126.7917 127.2500
#> 1950 131.2500 133.0833 134.9167
#>           Sep      Oct      Nov      Dec
#> 1949 127.9583 128.5833 129.0000 129.7500
#> 1950
method = "recursive"로 지정하면 이동평균이 아니라, 이전 시점의 결과가 다음 시점 계산에 재귀적으로 반영되는 계열을 만들어 낼 수 있습니다. 예를 들어 백색잡음(순수한 무작위 값)에 y[t] = 0.7 * y[t-1] + x[t]를 적용하면, 인접한 값들이 서로 닮아가는(자기상관이 생기는) 인공 시계열을 만들 수 있습니다.
set.seed(1)
x <- rnorm(10)
y <- filter(x, filter = 0.7, method = "recursive")
round(y, 3)
#> Time Series:
#> Start = 1
#> End = 10
#> Frequency = 1
#>  [1] -0.626 -0.255 -1.014  0.885  0.949 -0.156  0.378  1.003  1.278  0.589
이렇게 filter(method = "recursive")로 생성한 계열은 사실 뒤에서 다룰 AR(1) 모형, 즉 arima(order = c(1,0,0))으로 적합할 수 있는 데이터를 만드는 방법과 정확히 같습니다. 필터링과 자기회귀 모형이 근본적으로 같은 개념(과거 값들의 선형결합)에서 출발한다는 것을 보여주는 좋은 예입니다.
시계열 분해: decompose(), stl()
AirPassengers에는 추세, 계절성, 그리고 이 둘로 설명되지 않는 불규칙한 변동이 뒤섞여 있습니다. 이 세 성분을 각각 따로 떼어내 볼 수 있다면, "장기적인 성장세는 어느 정도인가", "계절에 따른 변동 폭은 얼마나 되는가"를 따로 파악할 수 있고, 계절성을 제거한 값(계절조정, seasonal adjustment)만 비교하는 것도 가능해집니다.
decompose()
decompose(x, type = c("additive", "multiplicative"), filter = NULL)는 시계열 x를 추세(trend)·계절(seasonal)·불규칙(random) 성분으로 분해하는, 가장 고전적인 방법입니다.
주요 인자
x:frequency가 1보다 큰(계절 주기가 있는)ts객체.type: 성분이 결합되는 방식."additive"(기본값) : 관측값 = 추세 + 계절 + 불규칙. 계절 변동의 폭이 시계열의 수준(크기)과 무관하게 일정하다고 가정합니다."multiplicative": 관측값 = 추세 × 계절 × 불규칙. 계절 변동의 폭이 수준에 비례해서 커진다고 가정합니다.AirPassengers처럼 시간이 갈수록 오르내림의 진폭 자체가 커지는 데이터에 더 적합합니다.filter: 추세를 뽑아낼 때 사용할 이동평균 가중치를 직접 지정합니다. 생략하면 9.5.4절에서 다룬 것과 같은 방식의 대칭 중심이동평균을 자동으로 사용합니다.
type = "additive"(기본값)로 분해하면, 반환된 리스트 안에 원자료(x)·계절(seasonal)·추세(trend)·불규칙(random) 네 시계열과, 한 주기 안의 계절지수 12개(figure)가 들어 있습니다.
dc <- decompose(AirPassengers)
str(dc)
#> List of 6
#>  $ x       : Time-Series [1:144] from 1949 to 1961: 112 118 132 129 121 135 148 148 136 119 ...
#>  $ seasonal: Time-Series [1:144] from 1949 to 1961: -24.75 -36.19 -2.24 -8.04 -4.51 ...
#>  $ trend   : Time-Series [1:144] from 1949 to 1961: NA NA NA NA NA ...
#>  $ random  : Time-Series [1:144] from 1949 to 1961: NA NA NA NA NA ...
#>  $ figure  : num [1:12] -24.75 -36.19 -2.24 -8.04 -4.51 ...
#>  $ type    : chr "additive"
#> - attr(*, "class")= chr "decomposed.ts"

round(dc$figure, 2)   # 1~12월의 평균적인 계절 편차
#>  [1] -24.75 -36.19  -2.24  -8.04  -4.51  35.40  63.83  62.82  16.52 -20.64
#> [11] -53.59 -28.62
계절지수(figure)를 보면 7월(63.83)과 8월(62.82)에는 그 해 평균 추세보다 약 63천 명 더 많은 승객이, 반대로 11월(-53.59)에는 약 54천 명 더 적은 승객이 몰린다는 것을 숫자로 확인할 수 있습니다. 추세(trend)는 12개월 중심이동평균으로 계산되므로, 앞뒤 6개월씩 이웃이 없는 맨 처음과 맨 끝 구간은 값을 낼 수 없어 NA로 남습니다.
round(head(dc$trend, 8), 2)
#>         Jan    Feb    Mar    Apr    May    Jun    Jul    Aug
#> 1949     NA     NA     NA     NA     NA     NA 126.79 127.25

round(tail(dc$trend, 8), 2)
#>         May    Jun    Jul    Aug    Sep    Oct    Nov    Dec
#> 1960 472.75 475.04     NA     NA     NA     NA     NA     NA
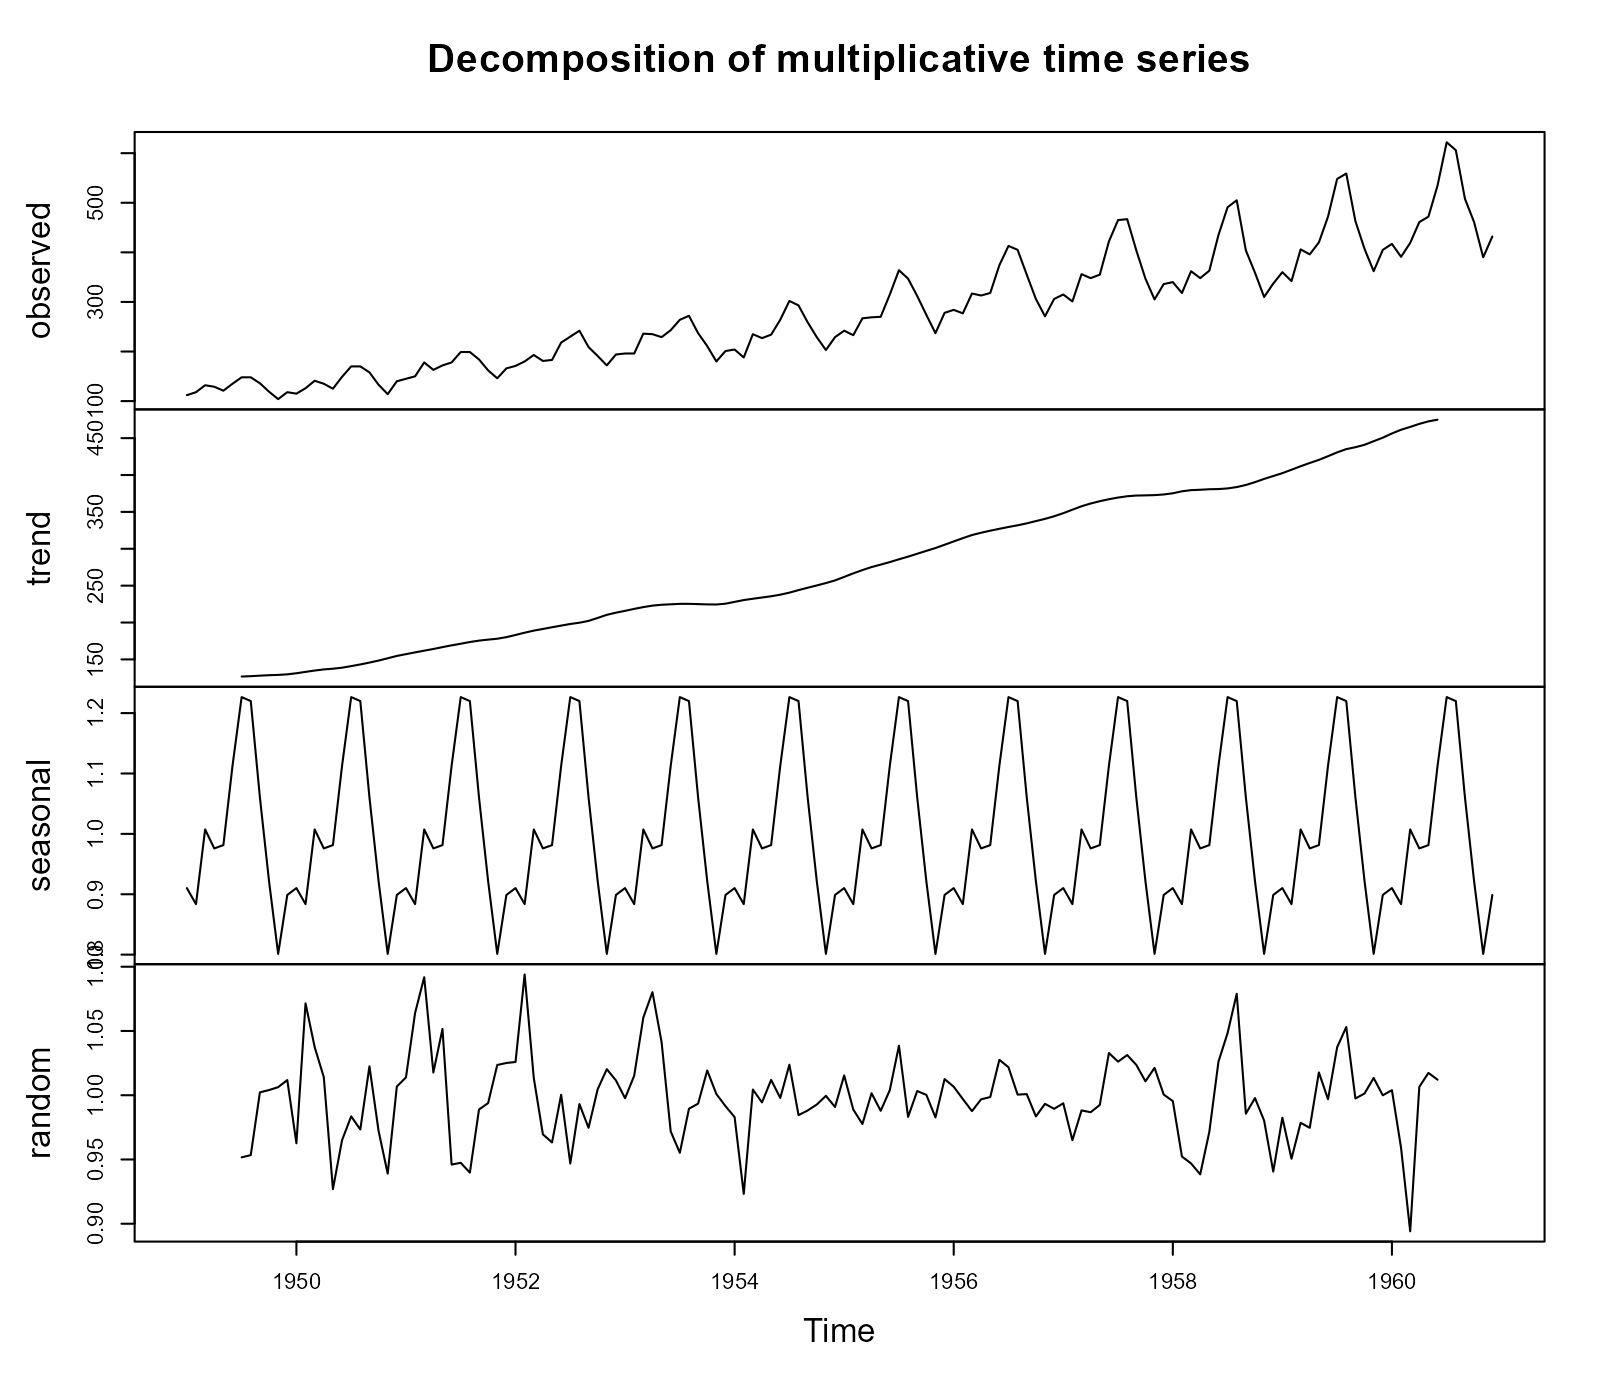
앞서 그래프에서 관찰했듯 이 데이터는 시간이 갈수록 계절 변동의 폭 자체가 커지므로, type = "multiplicative"로 분해하는 편이 더 알맞습니다. 이때 계절지수는 편차(더하고 빼는 값)가 아니라 비율(곱하는 값)로 나타납니다.
dcm <- decompose(AirPassengers, type = "multiplicative")
round(dcm$figure, 3)
#>  [1] 0.910 0.884 1.007 0.976 0.981 1.113 1.227 1.220 1.060 0.922 0.801 0.899
1월의 계절지수 0.910은 "1월은 평소 추세보다 약 9% 낮다"는 뜻이고, 7월의 1.227은 "7월은 평소 추세보다 약 23% 높다"는 뜻으로 해석합니다. 분해 결과를 한눈에 확인하려면 전용 plot() 메서드를 사용합니다(아래는 그래프를 그리는 코드만 제시하며, 실행은 각자의 R 환경에서 진행하면 됩니다).
stl()
stl(x, s.window, s.degree = 0, t.window = NULL, t.degree = 1, l.window = nextodd(period), l.degree = t.degree, s.jump, t.jump, l.jump, robust = FALSE, inner, outer, na.action = na.fail)는 Loess를 이용한 계절·추세 분해(Seasonal and Trend decomposition using Loess)의 약자로, decompose()보다 훨씬 유연하고 최근에 더 널리 권장되는 분해 방법입니다.
주요 인자
x: 분해할ts객체.decompose()와 달리type(가법/승법) 인자가 따로 없고, 자료를 미리log()변환하면 승법 관계를 가법 관계로 바꾸어 다룰 수 있습니다.s.window: 계절 성분을 얼마나 매끄럽게(또는 해마다 다르게) 추정할지 조절하는 창(window) 크기입니다. 문자열"periodic"을 지정하면 매해 계절 패턴이 완전히 동일하다고 가정하고(decompose()와 비슷한 방식), 홀수 정수를 지정하면 그 값이 클수록 계절 패턴이 해마다 서서히 변하는 것을 허용합니다. 이 인자는 기본값이 없어 반드시 지정해야 합니다.t.window: 추세를 추정할 때 사용할 국소 구간의 폭. 생략하면 자료와s.window를 바탕으로 적절한 값이 자동 계산됩니다.robust:TRUE로 지정하면 이상치의 영향을 반복적으로 줄여 가며 분해하는 로버스트 방식을 사용합니다(9.4절loess()의family = "symmetric"과 같은 발상).s.degree,t.degree,l.degree: 각각 계절·추세·저역통과(low-pass) 평활에 사용할 국소 다항식의 차수(0 또는 1)입니다.s.jump,t.jump,l.jump: 계산 속도를 높이기 위해 몇 지점 간격으로 건너뛰며 계산할지 지정하는 근사 옵션입니다.inner,outer: 각각 내부(추세·계절 추정) 반복 횟수와 외부(로버스트 가중치 갱신) 반복 횟수입니다.
가장 널리 쓰이는 방식은 s.window = "periodic"으로 지정해 매년 동일한 계절 패턴을 가정하는 것입니다.
st <- stl(AirPassengers, s.window = "periodic")
head(st$time.series, 6)
#>       seasonal    trend   remainder
#> 1 -25.497718 127.1873  10.3103699
#> 2 -35.220935 126.6495  26.5714028
#> 3  -3.027478 126.1117   8.9157625
#> 4  -8.299054 126.1989  11.1001224
#> 5  -5.737289 126.2861   0.4511408
#> 6  32.336634 126.7330 -24.0696572
decompose()와 마찬가지로 seasonal(계절) + trend(추세) + remainder(불규칙, decompose()의 random에 해당)로 분해된 결과를 얻을 수 있습니다. summary()로 각 성분이 전체 변동을 얼마나 설명하는지 요약할 수 있습니다.
summary(st)
#> ...
#> IQR:
#>     STL.seasonal STL.trend STL.remainder data
#>       48.22       188.41     21.14        180.50
#>    %  26.7        104.4      11.7         100.0
#> ...
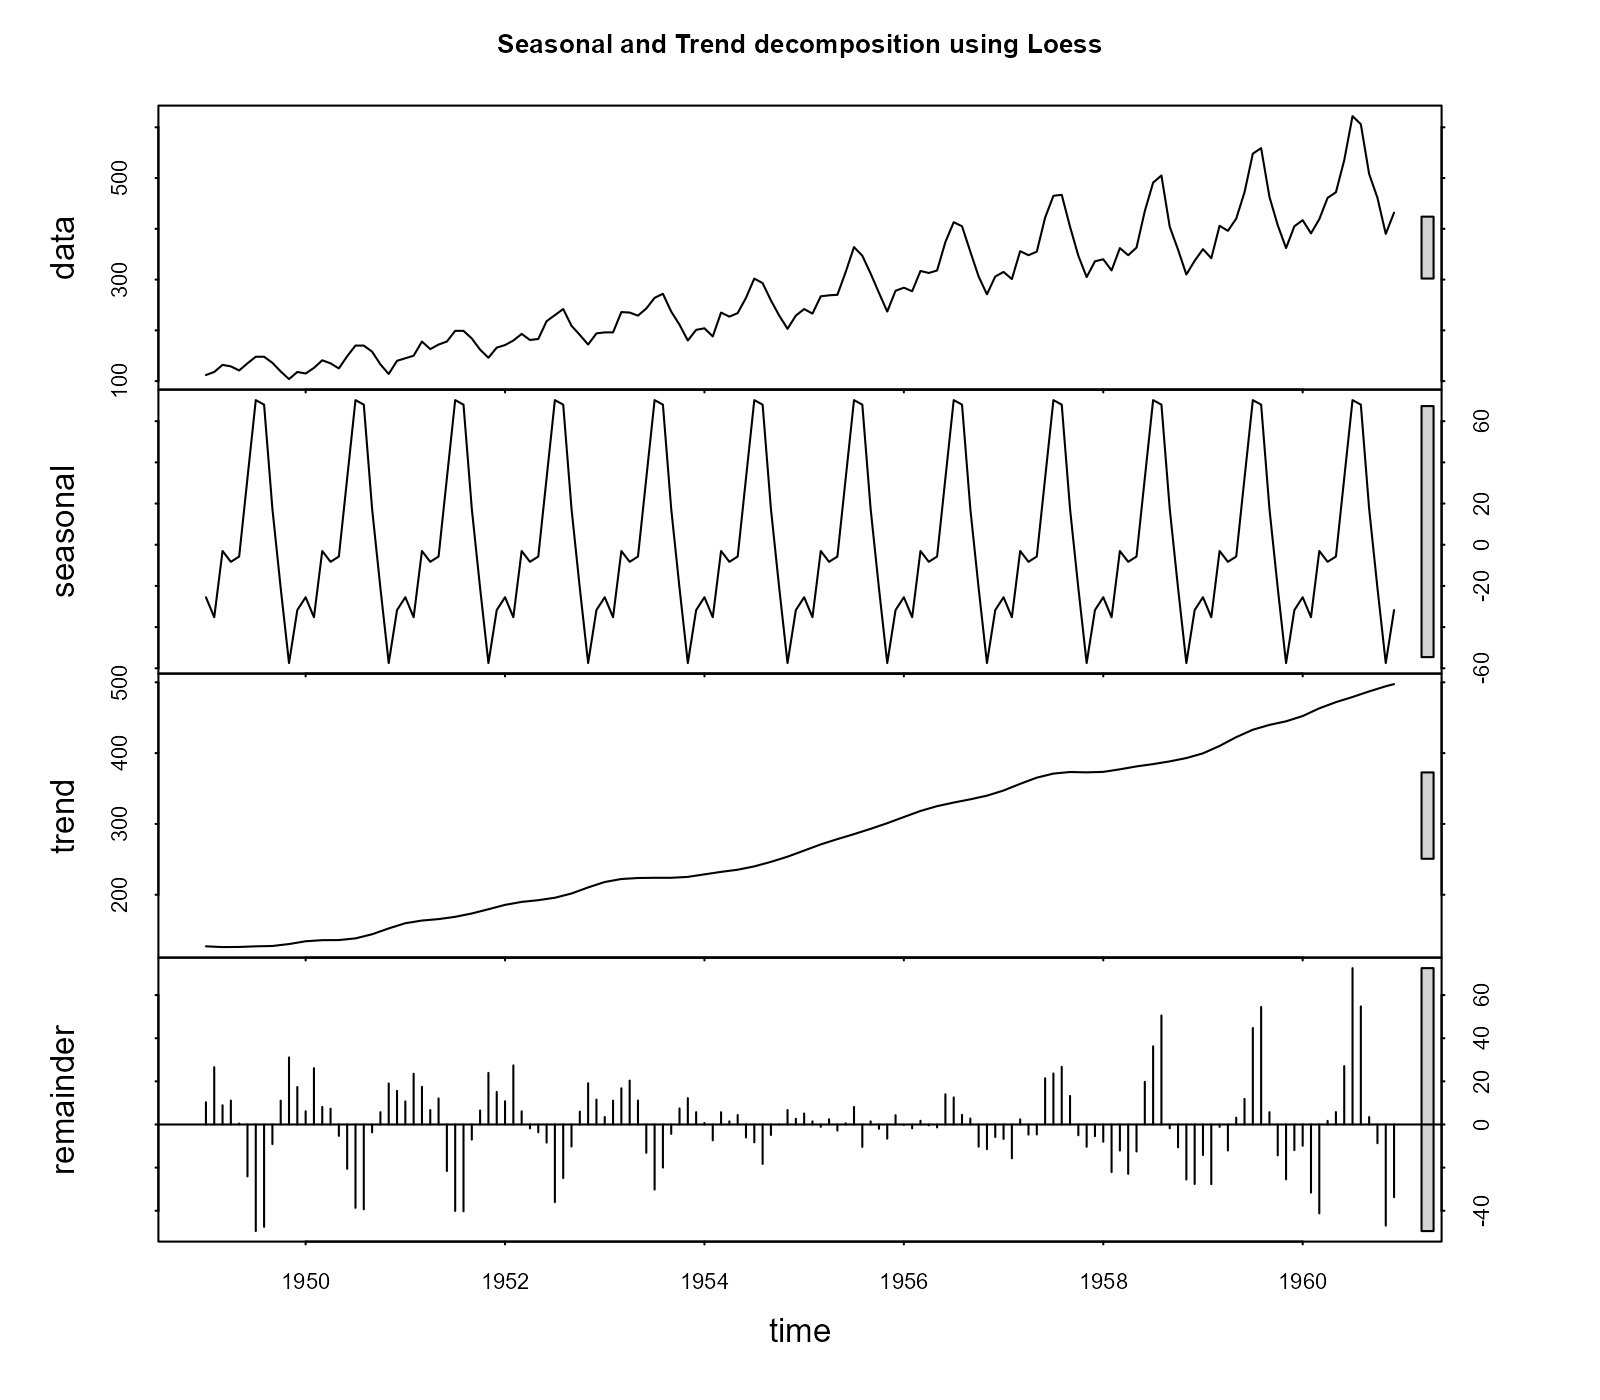
decompose()는 이동평균 창의 절반(6개월)만큼 시계열의 처음과 끝에서 trend가 NA가 되는 반면, stl()은 국소회귀(Loess)를 이용하므로 양 끝에서도 NA 없이 값을 추정해 준다는 실용적인 장점이 있습니다. 이 때문에 최근에는 decompose()보다 stl()이 더 권장되는 편입니다.
plot(stl(AirPassengers, s.window = "periodic"),
     main = "Seasonal and Trend decomposition using Loess")
자기상관 분석: acf(), pacf(), ccf(), Box.test()
시계열에서는 "같은 변수의 현재 값과 몇 시점 전 값" 사이의 관계, 즉 자기상관(autocorrelation) 이 핵심 질문이 됩니다. 자기상관의 패턴을 보면 뒤에서 다룰 ar()·arima() 모형에서 몇 시점 전 값까지 고려해야 할지에 대한 실마리를 얻을 수 있습니다.
acf(x, lag.max = NULL, type = c("correlation", "covariance", "partial"), plot = TRUE, na.action = na.fail, demean = TRUE, ...)는 시계열 x의 자기상관함수(ACF), 즉 시차(lag) 0, 1, 2, ...에 대한 자기상관계수를 계산하는 함수입니다.
주요 인자
x: 분석할 시계열.lag.max: 몇 시차까지 계산할지 지정합니다. 생략하면 관측치 개수에 따라 적당한 값이 자동으로 정해집니다.type:"correlation"(기본값, 자기상관계수),"covariance"(자기공분산),"partial"(편자기상관 — 다만 이 용도로는 아래에서 다룰pacf()를 직접 쓰는 편이 더 일반적입니다) 중 선택합니다.plot:TRUE(기본값)이면 자기상관 그래프를 그리고,FALSE이면 계산 결과만 반환하고 그래프는 그리지 않습니다.demean:TRUE(기본값)이면 평균을 뺀 뒤 자기상관을 계산합니다.na.action: 결측치 처리 방법. 기본값na.fail은 결측치가 있으면 오류를 냅니다.
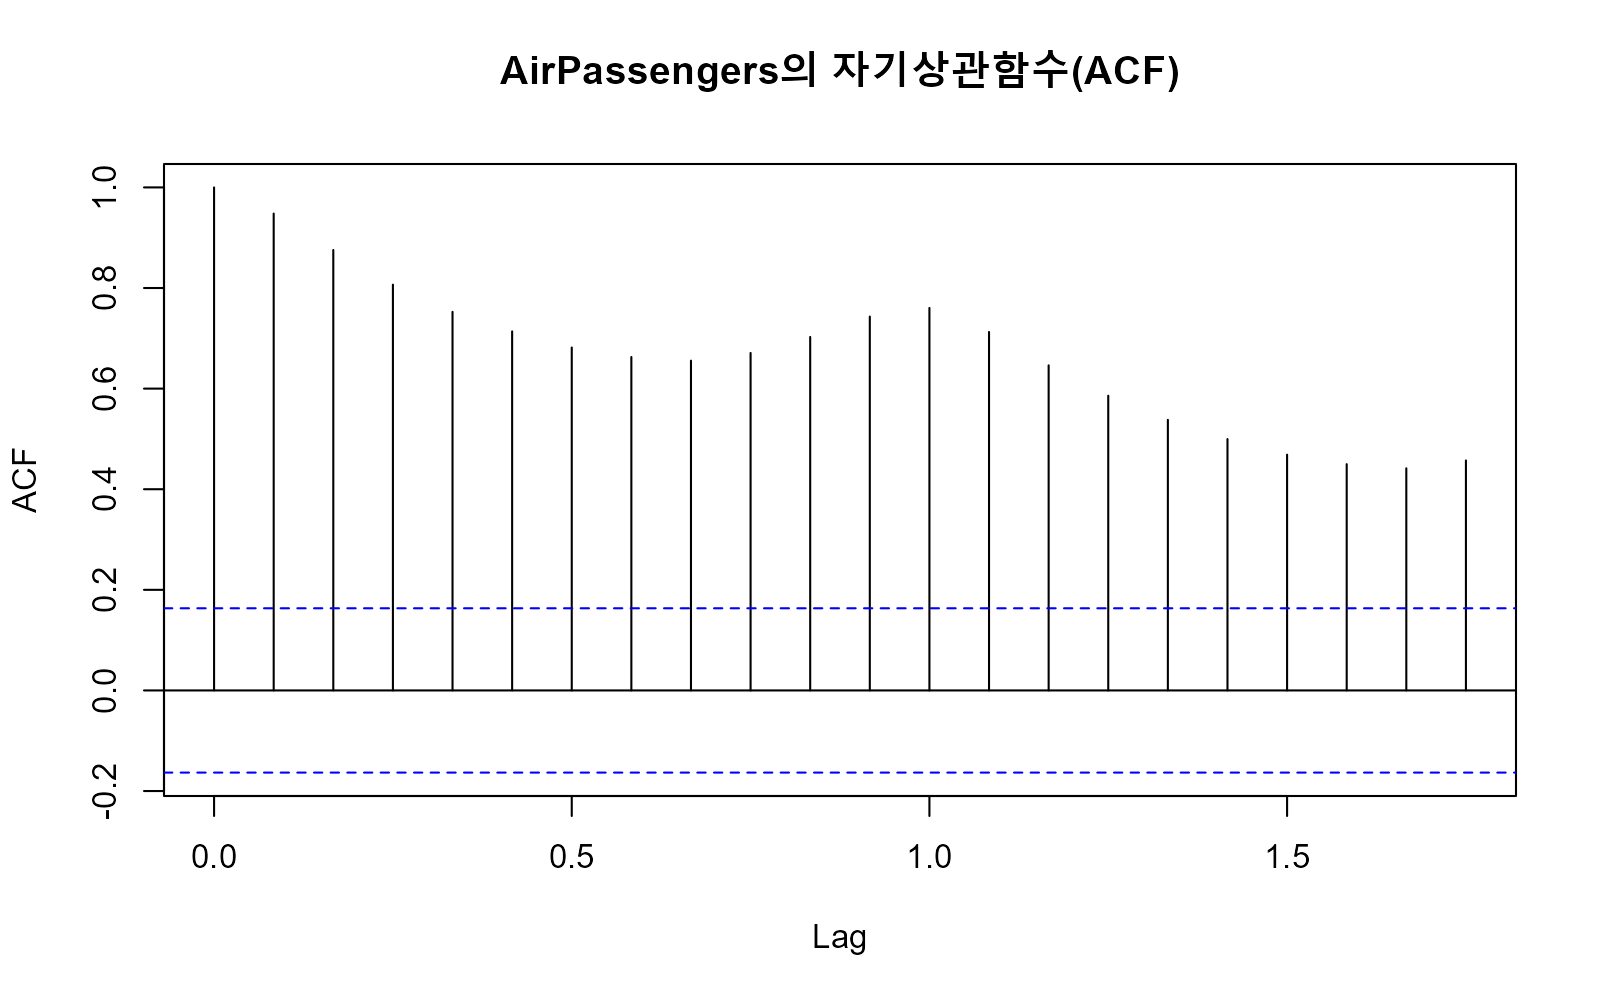
plot = FALSE로 지정해 그래프 대신 숫자만 확인해 보면 다음과 같습니다(월별 자료이므로 시차 축은 "년" 단위로 표시되어, 1은 시차 12개월 즉 1년을 뜻합니다).
acf(AirPassengers, lag.max = 12, plot = FALSE)
#> Autocorrelations of series 'AirPassengers', by lag
#>
#> 0.0000 0.0833 0.1667 0.2500 0.3333 0.4167 0.5000 0.5833 0.6667 0.7500 0.8333
#>  1.000  0.948  0.876  0.807  0.753  0.714  0.682  0.663  0.656  0.671  0.703
#> 0.9167 1.0000
#>  0.743  0.760
시차 1개월(0.0833)에서 상관계수가 0.948로 매우 높고, 시차가 늘어날수록 서서히 낮아지다가 시차 12개월(1.0000, 즉 1년)에서 다시 0.760으로 살짝 튀어 오릅니다. 값이 천천히 감소하는 모양은 강한 추세가 남아 있다는 신호이고, 12개월 근처에서 다시 높아지는 것은 계절성이 남아 있다는 신호입니다. 실제로 그래프(plot = TRUE, 기본값)를 그리면 이 상관계수들과 함께 "통계적으로 유의한 상관인지" 판단할 수 있는 파란 점선(근사 95% 신뢰한계)이 함께 표시됩니다.
pacf(x, lag.max, plot, na.action, ...)는 편자기상관함수(PACF), 즉 그 사이 시차들의 영향을 통계적으로 제거한 뒤 남는 "순수한" 시차별 상관을 계산합니다. 인자 구성은 acf()와 거의 같습니다.
pacf(AirPassengers, lag.max = 12, plot = FALSE)
#> Partial autocorrelations of series 'AirPassengers', by lag
#>
#> 0.0833 0.1667 0.2500 0.3333 0.4167 0.5000 0.5833 0.6667 0.7500 0.8333 0.9167 1.0000
#>  0.948 -0.229  0.038  0.094  0.074  0.008  0.126  0.090  0.232  0.166  0.171 -0.135
시차 1개월에서만 0.948로 뚜렷하게 크고, 그 이후로는 상대적으로 작다는 점이 눈에 띕니다. 시차 2 이후로 급격히 잦아드는 PACF 모양은 뒤에서 다룰 ar()가 비교적 낮은 차수를 자동으로 선택하는 것과도 맥이 닿아 있습니다.
💡 ACF와 PACF로 모형의 차수를 가늠하는 요령(Box-Jenkins 식별): 전통적인 시계열 분석에서는 ACF·PACF의 감쇠 패턴을 보고 잠정적인 모형 차수를 가늠합니다. 대략적으로 ACF가 특정 시차 이후 뚝 끊기고 PACF가 서서히 감소하면 이동평균(MA) 성분이, 반대로 PACF가 뚝 끊기고 ACF가 서서히 감소하면 자기회귀(AR) 성분이 두드러진다고 해석합니다. 다만 이는 어디까지나 잠정적인 출발점일 뿐이며, 최종적으로는 뒤에서 다룰
arima()로 여러 차수를 적합해 보고 AIC(9.6절)나 잔차 진단으로 비교해 결정하는 것이 안전합니다.
ccf(x, y, lag.max = NULL, type = c("correlation", "covariance"), plot = TRUE, na.action = na.fail, ...)는 교차상관함수(CCF) 로, 서로 다른 두 시계열 x, y 사이의 시차별 상관을 계산합니다. 예를 들어 y가 x보다 3개월 정도 늦게 반응하는 인공 자료를 만들어 확인해 보겠습니다.
set.seed(2)
x <- ts(cumsum(rnorm(100)))
y <- lag(x, k = -3) + rnorm(100, sd = 0.5)   # y는 x보다 3기 늦게 반응

cc <- ccf(x, y, lag.max = 6, plot = FALSE)
data.frame(lag = as.vector(cc$lag), ccf = round(as.vector(cc$acf), 3))
#>    lag   ccf
#> 1   -6 0.614
#> 2   -5 0.717
#> 3   -4 0.815
#> 4   -3 0.913
#> 5   -2 0.859
#> 6   -1 0.822
#> 7    0 0.770
#> 8    1 0.678
#> 9    2 0.605
#> 10   3 0.542
#> 11   4 0.487
#> 12   5 0.453
#> 13   6 0.445

cc$lag[which.max(cc$acf)]
#> [1] -3
상관계수가 시차 -3에서 0.913으로 가장 크게 나타나, "y는 x보다 3기 뒤처져 있다"는 자료를 생성한 그대로의 관계를 정확히 되짚어 낸 것을 확인할 수 있습니다.
Box.test(x, lag = 1, type = c("Box-Pierce", "Ljung-Box"), fitdf = 0)는 ACF 그래프를 눈으로 보는 대신, "여러 시차에 걸쳐 자기상관이 전혀 없다"는 귀무가설을 하나의 검정 통계량으로 종합해 검정하는 함수입니다.
주요 인자
x: 검정할 시계열(주로 모형의 잔차).lag: 몇 시차까지의 자기상관을 함께 검정할지 지정합니다.type:"Box-Pierce"(전통적인 방식)와"Ljung-Box"(표본이 작을 때 더 정확하게 근사하는 개선된 방식, 실무에서 더 널리 쓰임) 중 선택합니다.fitdf: 이미 어떤 모형(예:arima())을 적합한 뒤 그 잔차를 검정하는 경우, 그 모형이 추정한 모수의 개수를 지정해 자유도를 보정합니다. 원자료 자체를 검정할 때는 기본값0을 그대로 둡니다.
Box.test(AirPassengers, lag = 12, type = "Ljung-Box")
#>
#>  Box-Ljung test
#>
#> data:  AirPassengers
#> X-squared = 1036.5, df = 12, p-value < 2.2e-16
p-값이 극히 작아, "12시차까지 자기상관이 전혀 없다"는 귀무가설을 강하게 기각합니다. 원자료에 추세·계절성이 그대로 남아 있는 AirPassengers라면 당연한 결과이며, 이 검정은 원자료보다는 뒤에서 다룰 arima() 적합 후 "잔차에 자기상관이 남아 있지 않은가"를 확인하는 모형 진단 용도로 훨씬 자주 사용됩니다.
자기회귀 모형: ar()
AirPassengers의 PACF가 시차 1에서 크게 튀고 그 이후로는 상대적으로 잦아드는 것을 보았습니다. 이는 "오늘 값은 최근 몇 시점의 과거 값들의 (가중)합으로 상당 부분 설명된다"는 뜻이며, 이 관계를 직접 수식으로 적합해 미래를 예측하려는 것이 자기회귀(AR, AutoRegressive) 모형입니다.
ar(x, aic = TRUE, order.max = NULL, method = c("yule-walker", "burg", "ols", "mle", "yw"), na.action = na.fail, series = deparse1(substitute(x)), ...)는 시계열 x에 AR(p) 모형, 즉 x[t] = c + φ1*x[t-1] + φ2*x[t-2] + ... + φp*x[t-p] + e[t] 형태의 자기회귀 모형을 적합하는 함수입니다.
주요 인자
x: 적합할 시계열. 뒤에서 다룰arima()와 달리ar()은 차분(d)이나 이동평균(MA) 항 없이 순수한 AR 성분만 다루므로, 추세·계절성이 강하게 남아 있는 원자료보다는diff()(9.5.3절)로 어느 정도 정상화한 자료에 적용하는 것이 일반적입니다.aic:TRUE(기본값)이면1부터order.max까지 차수를 하나씩 늘려 가며 적합해 보고, AIC(9.6절)가 가장 작은 차수를 자동으로 선택합니다.FALSE로 지정하면order.max에 지정한 차수를 그대로 사용합니다.order.max: 탐색할(또는 고정할) 최대 차수. 생략하면 자료 길이에 따라 적당한 값이 자동으로 정해집니다.method: 계수 추정 방법."yule-walker"(기본값, 표본자기상관을 이용하는 전통적인 방법),"burg"(Burg 알고리즘),"ols"(최소제곱법),"mle"(최대가능도추정) 중 선택합니다. 방법에 따라 계산 속도와 짧은 표본에서의 안정성이 달라지지만, 표본이 충분히 크면 결과는 대체로 비슷합니다.na.action: 결측치 처리 방법.series: 결과 출력에 표시될 계열의 이름. 생략하면x에 넘긴 변수명을 자동으로 사용합니다.
R 문서에서도 자주 예시로 쓰이는 LakeHuron(휴런호의 연간 평균 수위, 1875~1972년) 데이터로 살펴보겠습니다. 연간 자료라 계절성이 없고 뚜렷한 AR 패턴만 남아 있어 ar()의 동작을 이해하기에 적합합니다.
data(LakeHuron)
fit_ar <- ar(LakeHuron)
fit_ar
#>
#> Call:
#> ar(x = LakeHuron)
#>
#> Coefficients:
#>       1        2
#>  1.0538  -0.2668
#>
#> Order selected 2  sigma^2 estimated as  0.5075
AIC 기준 자동 탐색 결과 AR(2) 모형, 즉 x[t] = c + 1.0538*x[t-1] - 0.2668*x[t-2] + e[t]가 선택되었습니다. 차수를 자동 탐색 없이 직접 지정하고 싶다면 aic = FALSE와 order.max를 함께 사용합니다.
적합된 ar 객체에 predict()를 적용하면 향후 시점의 예측값과 표준오차를 함께 얻을 수 있습니다.
predict(fit_ar2, n.ahead = 5)
#> $pred
#> Time Series:
#> Start = 1973
#> End = 1977
#> Frequency = 1
#> [1] 579.7751 579.5616 579.3860 579.2578 579.1696
#>
#> $se
#> Time Series:
#> Start = 1973
#> End = 1977
#> Frequency = 1
#> [1] 0.7124111 1.0349711 1.1968798 1.2728709 1.3068764
예측값이 최근 관측치 수준(약 580 부근)에서 서서히 완만한 값으로 수렴하고, 예측 시점이 멀어질수록 표준오차(se)가 커져 불확실성이 늘어나는 것을 확인할 수 있습니다.
ARIMA 모형: arima()
ar()는 순수한 자기회귀(AR) 성분만 다루고, 추세를 제거하려면 diff()로 미리 차분을 해 두어야 했습니다. 그런데 실제 자료에는 AR 성분뿐 아니라 "최근 몇 번의 예측 오차가 다음 값에 영향을 준다"는 이동평균(MA) 성분이 섞여 있는 경우도 많고, 차분(정상화)까지 모형 안에서 한 번에 처리할 수 있다면 훨씬 편리할 것입니다. arima()는 AR, 차분(I, Integrated), MA 세 요소를 하나의 틀로 통합한 모형입니다.
arima(x, order = c(0L, 0L, 0L), seasonal = list(order = c(0L, 0L, 0L), period = NA), xreg = NULL, include.mean = TRUE, transform.pars = TRUE, fixed = NULL, init = NULL, method = c("CSS-ML", "ML", "CSS"), optim.method = "BFGS", optim.control = list(), kappa = 1e+06)는 ARIMA(p, d, q) (그리고 계절 성분까지 포함한 SARIMA) 모형을 적합하는 함수입니다.
주요 인자
x: 적합할 시계열.order:c(p, d, q)형태로 지정하는 비계절 차수.p는 AR 차수,d는 차분 횟수(9.5.3절의diff()를 모형 안에서 자동으로 수행),q는 MA 차수입니다.seasonal: 계절 성분을 위한list(order = c(P, D, Q), period = s)형태의 목록입니다.period는 계절 주기(월별 자료라면 보통12)이며,P,D,Q는 각각 계절 AR·계절 차분·계절 MA 차수로, 비계절 성분과 같은 의미를period시차 간격으로 적용합니다.xreg: 시계열 자체의 과거 값 외에, 함께 반영하고 싶은 외부 설명변수(회귀변수)가 있다면 행렬 형태로 지정합니다.include.mean: 모형에 절편(평균 수준)을 포함할지 여부입니다. 보통d > 0으로 이미 차분을 한 경우에는 평균이 0에 가까워지므로 자동으로 제외됩니다.method: 모수 추정 방법."CSS-ML"(기본값, 조건부제곱합으로 초기값을 잡은 뒤 최대가능도추정으로 정교화)이 대부분 상황에서 안정적입니다.transform.pars,fixed,init,optim.method,optim.control,kappa: 최적화 과정을 세밀하게 제어하는 고급 옵션들로, 특별한 수렴 문제가 없다면 기본값을 그대로 사용해도 충분합니다.
AirPassengers처럼 시간이 갈수록 계절 변동의 폭이 커지는(승법적인) 자료는, 값 자체가 아니라 로그를 취한 값에 모형을 적합하면 승법 관계가 가법 관계로 바뀌어 훨씬 다루기 쉬워집니다. 이 자료에 특히 잘 맞는 것으로 알려진 ARIMA(0,1,1)(0,1,1)[12] 모형(흔히 항공권 모형, airline model이라고 부릅니다)을 적합해 보겠습니다.
lp <- log(AirPassengers)
fit <- arima(lp, order = c(0, 1, 1), seasonal = list(order = c(0, 1, 1), period = 12))
fit
#>
#> Call:
#> arima(x = lp, order = c(0, 1, 1), seasonal = list(order = c(0, 1, 1), period = 12))
#>
#> Coefficients:
#>           ma1     sma1
#>       -0.4018  -0.5569
#> s.e.   0.0896   0.0731
#>
#> sigma^2 estimated as 0.001348:  log likelihood = 244.7,  aic = -483.4
비계절 차분(d = 1)과 계절 차분(D = 1, 12개월 간격)을 각각 한 번씩 적용한 뒤, 남은 값을 비계절 MA(1)·계절 MA(1)로 설명하는 모형입니다. coef()로 계수만, AIC()로 적합도 지표만 따로 뽑아낼 수 있고, confint()로 계수의 95% 신뢰구간도 확인할 수 있습니다.
coef(fit)
#>        ma1       sma1
#> -0.4018280 -0.5569448

AIC(fit)
#> [1] -483.3991

confint(fit)
#>           2.5 %     97.5 %
#> ma1  -0.5775267 -0.2261293
#> sma1 -0.7002176 -0.4136721
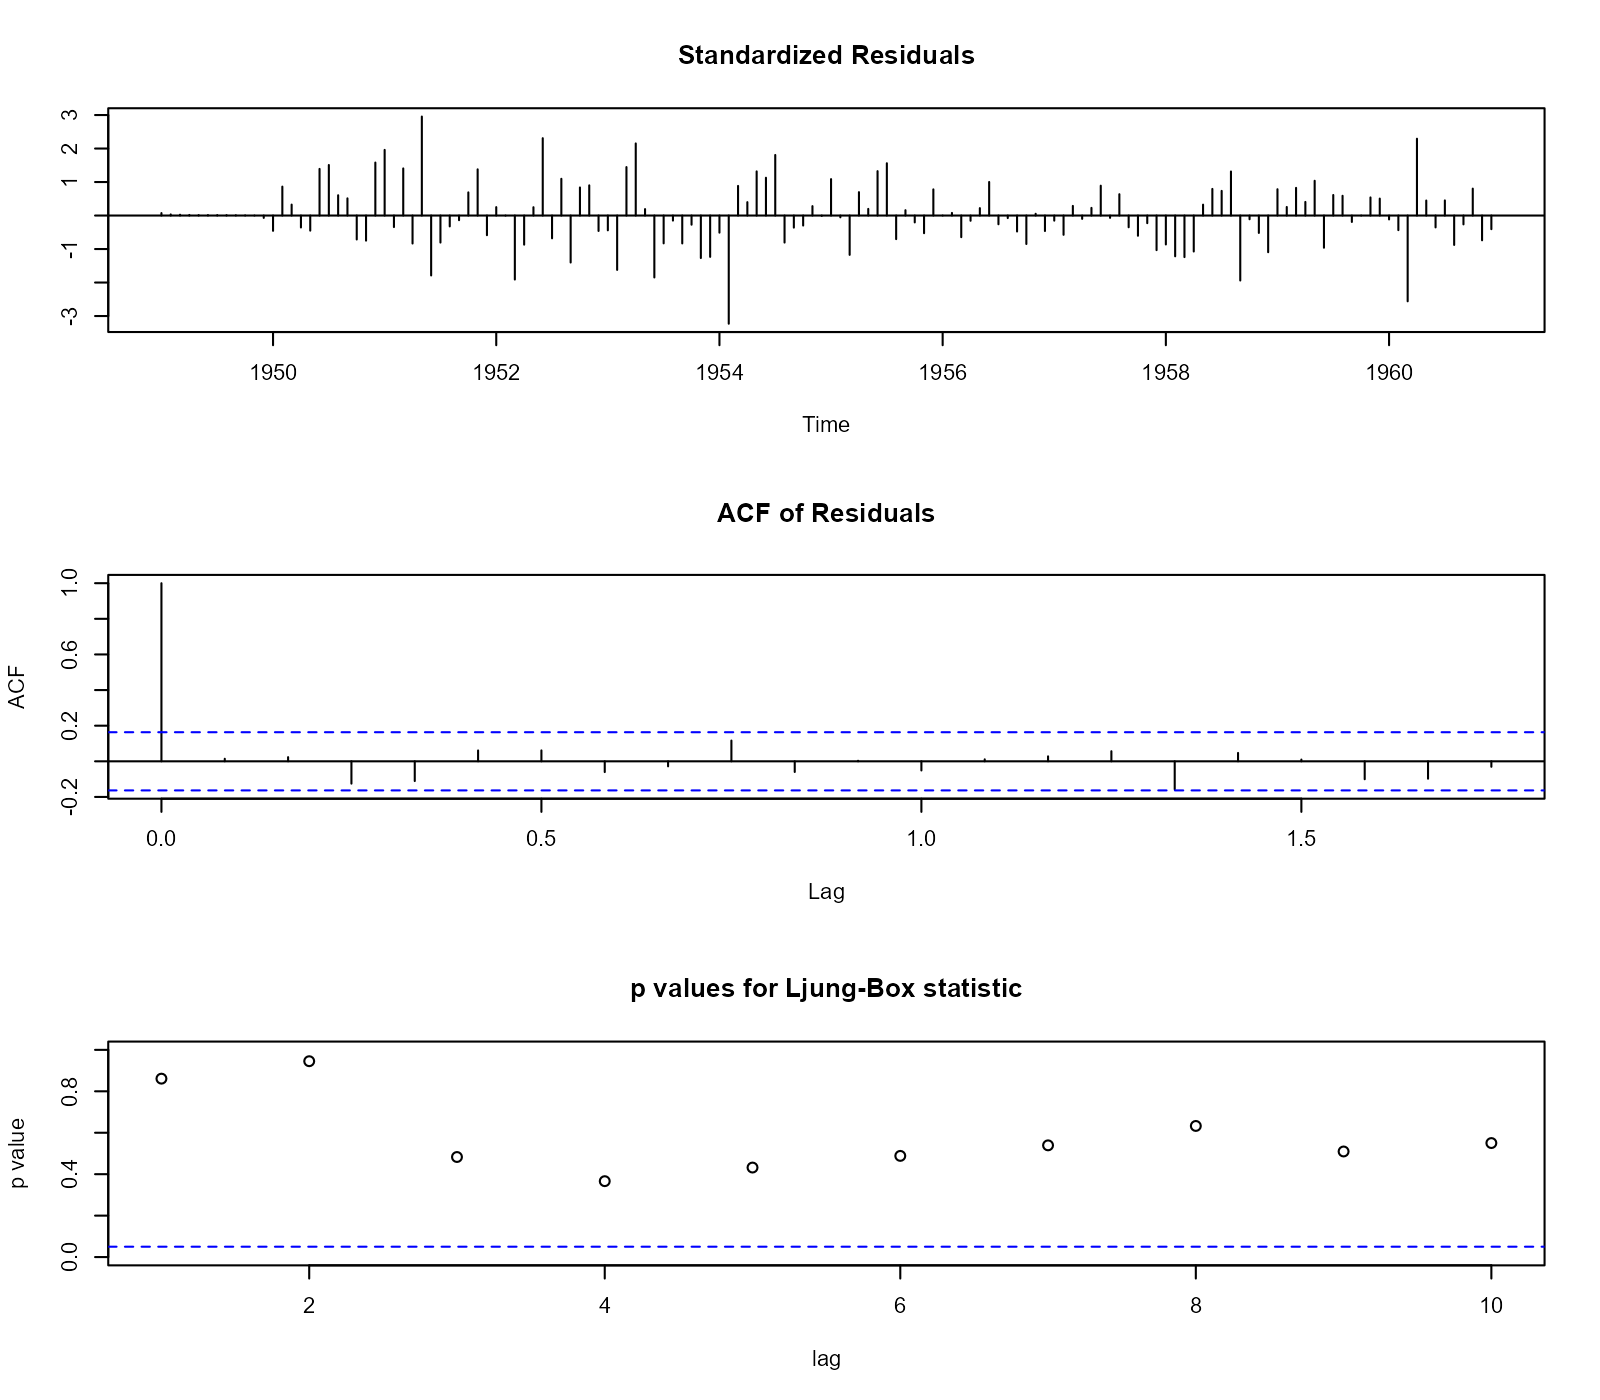
모형이 자기상관을 충분히 잘 설명했는지는 잔차에 자기상관이 남아 있지 않은지로 확인합니다. residuals(fit)로 잔차를 뽑아 Box.test()(9.5.6절)를 적용하되, 이번에는 모형이 이미 모수 2개(ma1, sma1)를 추정했으므로 fitdf = 2로 자유도를 보정합니다.
Box.test(residuals(fit), lag = 12, type = "Ljung-Box", fitdf = 2)
#>
#>  Box-Ljung test
#>
#> data:  residuals(fit)
#> X-squared = 9.2333, df = 10, p-value = 0.5101
p-값이 크므로(0.51), "잔차에 자기상관이 남아 있지 않다"는 귀무가설을 기각할 근거가 없습니다. 즉 이 모형이 원자료의 시간적 패턴을 충분히 잘 설명하고 있다고 볼 수 있습니다. 잔차의 ACF·정규성 등을 그래프로 한꺼번에 점검하고 싶다면 tsdiag(fit)을 사용합니다.
predict(object, n.ahead = 1L, newxreg = NULL, se.fit = TRUE, ...)로 향후 12개월(로그 스케일)을 예측한 뒤, exp()로 다시 원래 단위(승객 수)로 되돌릴 수 있습니다.
pred <- predict(fit, n.ahead = 12)
fc <- exp(pred$pred)                          # 예측값
lo <- exp(pred$pred - 1.96 * pred$se)         # 95% 신뢰구간 하한
hi <- exp(pred$pred + 1.96 * pred$se)         # 95% 신뢰구간 상한

round(fc, 1)
#>        Jan   Feb   Mar   Apr   May   Jun   Jul   Aug   Sep   Oct   Nov   Dec
#> 1961 450.4 425.7 479.0 492.4 509.1 583.3 670.0 667.1 558.2 497.2 429.9 477.2
1960년 12월 마지막 관측값(432천 명)에서 시작해, 이듬해에도 여름철에 정점(7월 약 670천 명)을 찍는 계절 패턴이 예측값에도 그대로 이어지는 것을 확인할 수 있습니다.
plot(AirPassengers, xlim = c(1949, 1962), ylim = c(0, 700),
     xlab = "연도", ylab = "승객 수(천 명)",
     main = "ARIMA(0,1,1)(0,1,1)[12] 예측")
lines(fc, col = "blue", lwd = 2)
lines(lo, col = "blue", lty = 3)
lines(hi, col = "blue", lty = 3)
(0,1,1)[12]%20예측.png)
💡 차수
(p, d, q)를 어떻게 정할까요? 실무에서는 ACF·PACF로 후보 차수를 몇 가지 가늠한 뒤, 후보 모형 여러 개를arima()로 각각 적합해AIC()값이 가장 작은(또는AIC()가 비슷하다면 더 단순한) 모형을 고르고, 마지막으로Box.test()·tsdiag()로 잔차에 자기상관이 남아 있지 않은지 확인하는 순서를 반복합니다. 이 반복 과정(차수 탐색 → 적합 → 진단)을 자동화해 주는auto.arima()같은 함수는forecast패키지에 있으며, Base R 범위를 벗어나므로 이 매뉴얼에서는 다루지 않습니다.
지수평활법: HoltWinters()
arima()는 강력하지만 차수 (p, d, q)를 탐색하고 해석하는 과정이 다소 번거롭습니다. 반면 "최근 값일수록 미래 예측에 더 큰 영향을 주어야 한다"는 훨씬 단순하고 직관적인 아이디어만으로도 추세와 계절성을 반영한 예측을 할 수 있습니다. 지수평활법(exponential smoothing) 은 과거로 갈수록 가중치를 기하급수적으로 줄여 가며 가중평균을 내는 방식으로, 계산이 단순하면서도 실무에서 널리 쓰입니다.
HoltWinters(x, alpha = NULL, beta = NULL, gamma = NULL, seasonal = c("additive", "multiplicative"), start.periods = 2, l.start = NULL, b.start = NULL, s.start = NULL, optim.start = c(alpha = 0.3, beta = 0.1, gamma = 0.1), optim.control = list())는 Holt-Winters 지수평활법으로 수준(level)·추세(trend)·계절(season) 세 성분을 동시에 추정하는 함수입니다.
| 종류 | 설정 | 의미 |
|---|---|---|
| 단순지수평활 (SES) | beta=FALSE, gamma=FALSE |
추세·계절성 없음, 수준(level)만 평활 |
| 이중지수평활 (Holt's method) | gamma=FALSE |
수준 + 추세(trend) 평활 |
| 삼중지수평활 (Holt-Winters) | 기본값(모두 TRUE) |
수준 + 추세 + 계절성(seasonal) 평활 |
주요 인자
x: 적합할 시계열.alpha,beta,gamma: 각각 수준, 추세, 계절 성분의 평활 계수(0~1)입니다. 값이1에 가까울수록 가장 최근 관측치의 비중이 커지고(민감하게 반응),0에 가까울수록 과거의 누적된 평균값을 더 중시합니다(둔감하게 반응). 세 값 모두 생략하면(기본값NULL) 과거 자료에 대한 예측오차제곱합(SSE)을 최소화하는 값을 자동으로 추정합니다.beta = FALSE또는gamma = FALSE로 지정하면 해당 성분(추세 또는 계절)을 아예 모형에서 제외할 수 있습니다.seasonal: 계절 성분의 결합 방식."additive"(기본값)와"multiplicative"중 선택하며,decompose()의type인자와 같은 기준으로 고르면 됩니다.start.periods: 초기값을 추정하기 위해 사용할 계절 주기의 개수(기본값 2).l.start,b.start,s.start: 수준·추세·계절 성분의 초기값을 직접 지정하고 싶을 때 사용합니다. 생략하면 자료의 앞부분으로부터 자동 계산됩니다.optim.start,optim.control:alpha·beta·gamma를 자동으로 추정할 때 사용하는 최적화의 시작값과 세부 옵션입니다.
AirPassengers는 계절 변동의 폭이 시간이 갈수록 커지므로, decompose()·arima()와 마찬가지로 seasonal = "multiplicative"가 더 알맞습니다.
fit_hw <- HoltWinters(AirPassengers, seasonal = "multiplicative")
fit_hw
#> Holt-Winters exponential smoothing with trend and multiplicative seasonal component.
#>
#> Call:
#> HoltWinters(x = AirPassengers, seasonal = "multiplicative")
#>
#> Smoothing parameters:
#>  alpha: 0.2755925
#>  beta : 0.03269295
#>  gamma: 0.8707292
#>
#> Coefficients:
#>            [,1]
#> a   469.3232206
#> b     3.0215391
#> s1    0.9464611
#> s2    0.8829239
#> s3    0.9717369
#> s4    1.0304825
#> s5    1.0476884
#> s6    1.1805272
#> s7    1.3590778
#> s8    1.3331706
#> s9    1.1083381
#> s10   0.9868813
#> s11   0.8361333
#> s12   0.9209877
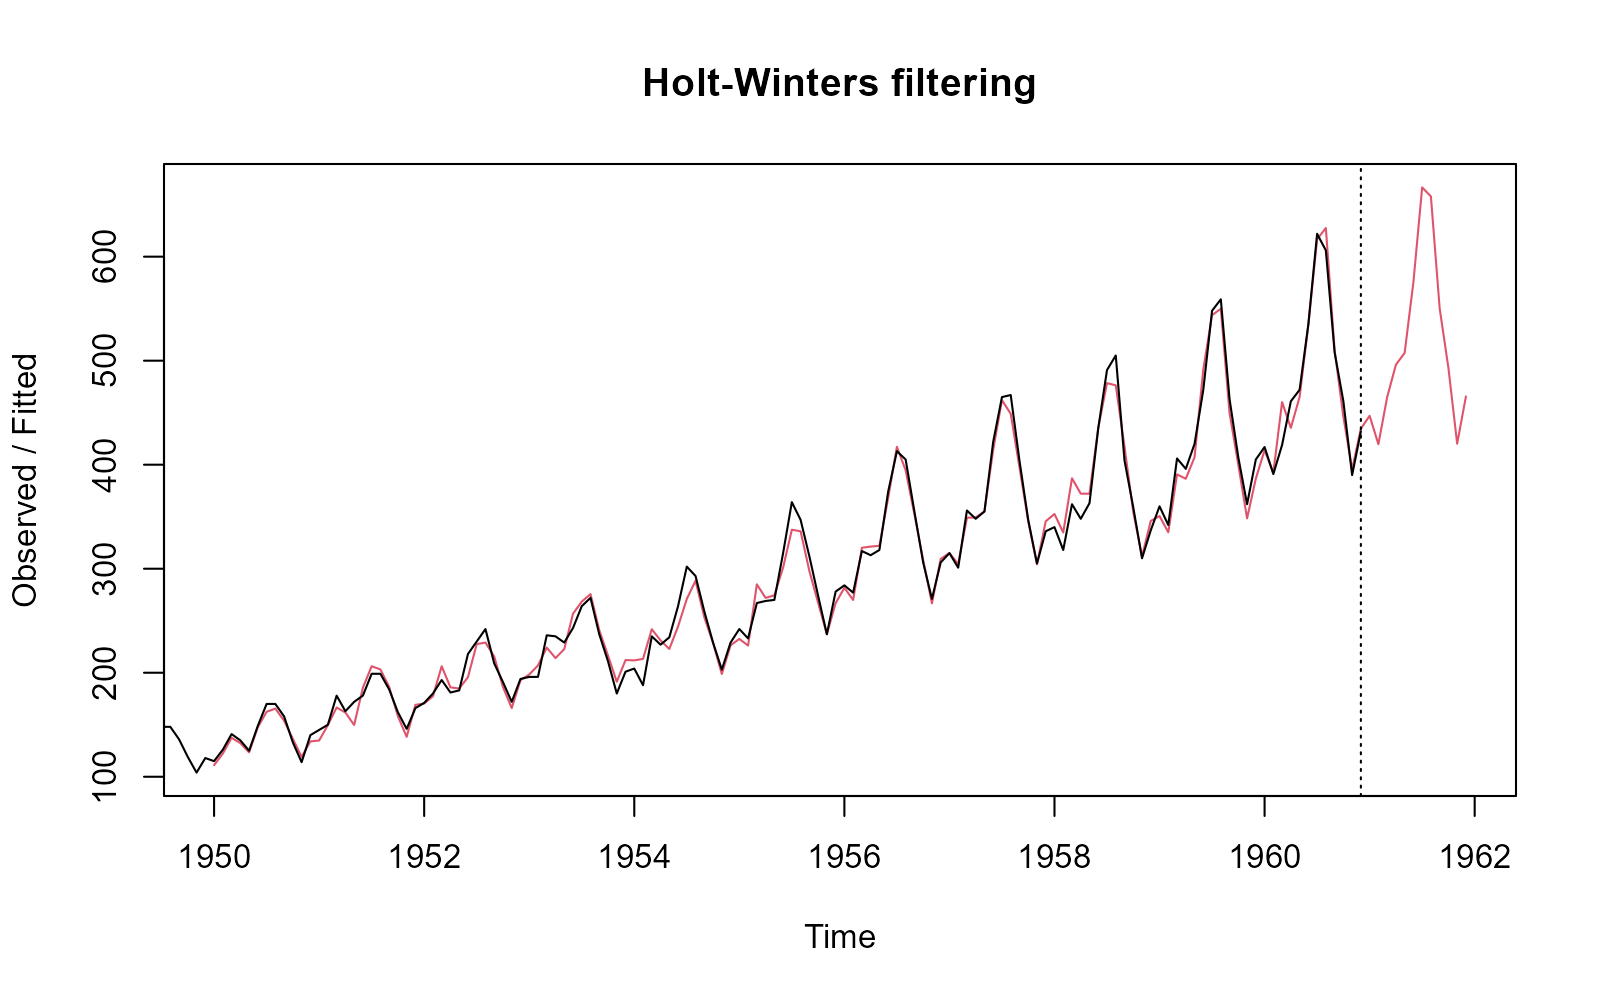
alpha(약 0.28)와 beta(약 0.03)는 비교적 작아 수준과 추세는 과거의 누적된 정보를 폭넓게 반영하는 반면, gamma(약 0.87)는 1에 가까워 계절 패턴은 최근 몇 년의 모양을 훨씬 민감하게 따라간다는 것을 알 수 있습니다. 적합도는 잔차제곱합(SSE)으로 확인합니다.
predict(object, n.ahead = 1L, prediction.interval = FALSE, level = 0.95, ...)로 향후 값을 예측합니다. prediction.interval = TRUE로 지정하면 예측값과 함께 신뢰구간(상한 upr, 하한 lwr)도 얻을 수 있습니다.
predict(fit_hw, n.ahead = 12, prediction.interval = TRUE, level = 0.95)
#>               fit      upr      lwr
#> Jan 1961 447.0559 466.8057 427.3061
#> Feb 1961 419.7123 440.2920 399.1326
#> Mar 1961 464.8671 486.7712 442.9630
#> Apr 1961 496.0839 519.3350 472.8329
#> May 1961 507.5326 531.9278 483.1375
#> Jun 1961 575.4509 602.1935 548.7083
#> Jul 1961 666.5923 696.5558 636.6288
#> Aug 1961 657.9137 688.6454 627.1821
#> Sep 1961 550.3088 578.9777 521.6398
#> Oct 1961 492.9853 520.9553 465.0153
#> Nov 1961 420.2073 446.9458 393.4688
#> Dec 1961 465.6345 487.9686 443.3004
arima()(항공권 모형)의 1961년 1월 예측값이 약 450.4였던 것과 HoltWinters()의 예측값 447.1이 상당히 비슷한 수준이라는 점도 눈여겨볼 만합니다. 서로 다른 원리(ARIMA vs 지수평활)로 접근해도 비슷한 결론에 도달한다면, 그만큼 예측을 신뢰할 근거가 하나 더 생기는 셈입니다.
추세나 계절성이 없는(또는 무시해도 좋은) 자료라면 beta = FALSE, gamma = FALSE로 지정해 단순지수평활(수준만 추정)로 단순화할 수 있습니다.
fit_ses <- HoltWinters(AirPassengers, beta = FALSE, gamma = FALSE)
fit_ses$alpha
#>     alpha
#> 0.9999339
추세·계절 성분 없이 수준 하나만으로 이렇게 추세와 계절성이 뚜렷한 자료를 억지로 따라가려다 보니, alpha가 거의 1(가장 최근 값에 거의 전적으로 의존)로 추정된 것입니다. 이는 "이 자료에는 단순지수평활만으로는 부족하고 추세·계절 성분이 반드시 필요하다"는 것을 역설적으로 보여주는 결과이기도 합니다.